


[산업 인사이트 11-1호] Autonomous Quality편
업체관리자
view : 45
4. AI 검사의 성패는 초기 정확도가 아니라 운영에서 결정된다
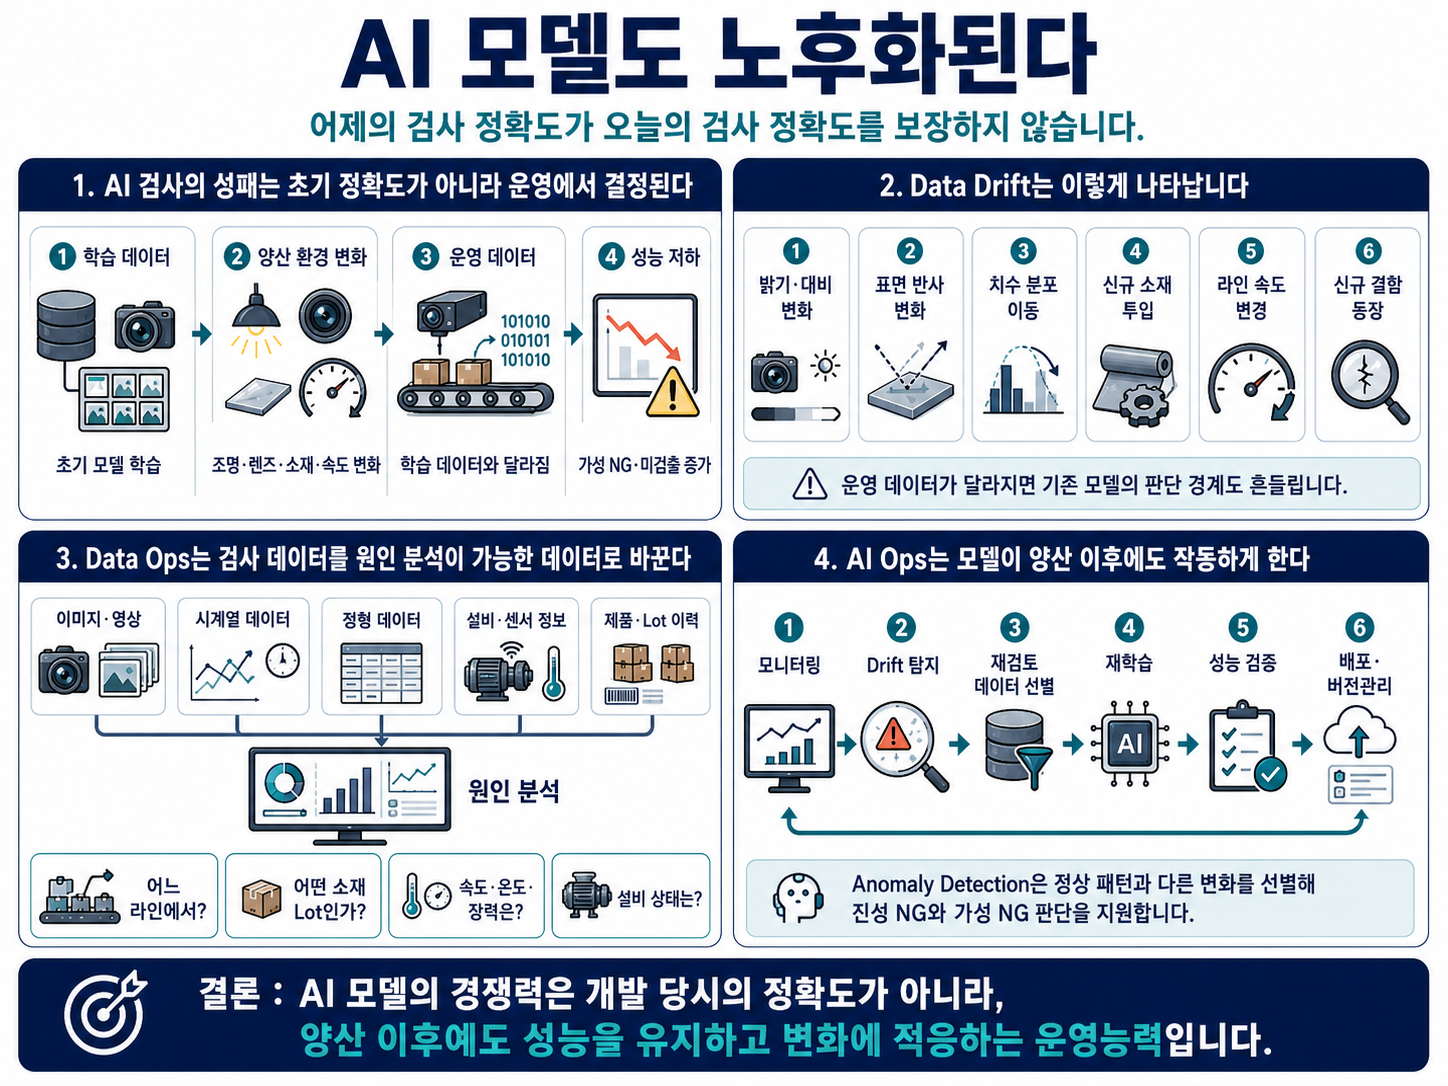
AI 검사 프로젝트에서는 모델 개발 당시의 정확도가 중요한 평가기준으로 사용됩니다.
하지만 높은 초기 정확도가 장기간의 안정적인 운영을 보장하지는 않습니다.
AI 모델은 특정 카메라, 조명, 소재, 제품 규격과 공정조건에서 수집된 데이터를 학습합니다.
양산 이후 조명이 어두워지거나 렌즈가 오염되고, 소재 표면의 반사 특성이 바뀌면 운영 데이터가 학습 데이터와 달라집니다.
제품 규격이나 품질기준이 변경되면 기존 모델이 학습한 정상과 불량의 경계도 달라질 수 있습니다.
이러한 변화를 Data Drift라고 합니다.
Microsoft는 머신러닝 모델이 코드에 정의된 Rule뿐 아니라 데이터로부터 동작방식을 학습하기 때문에 데이터 분포, 운영환경, 데이터 품질이 바뀌면 모델이 오래된 상태가 되고 성능이 저하될 수 있다고 설명합니다. 이에 따라 운영 중인 모델은 Data Drift, Prediction Drift, 데이터 품질과 실제 성능을 지속적으로 모니터링해야 합니다.
제조현장에서 Data Drift는 다음과 같은 형태로 나타납니다.
- 동일한 제품이지만 이미지 밝기와 대비가 달라집니다.
- 표면의 색상과 반사도가 달라집니다.
- 정상 제품의 치수 분포가 미세하게 이동합니다.
- 신규 소재나 부품이 투입됩니다.
- 라인 속도와 설비조건이 변경됩니다.
- 기존에 없던 결함 유형이 등장합니다.
- 고객의 품질 판정기준이 달라집니다.
이러한 변화가 누적되면 정상 제품을 불량으로 판정하는 가성 NG가 늘어나거나, 실제 불량을 놓치는 미검출 가능성이 높아집니다.
따라서 AI 검사는 모델을 한 번 개발하고 끝내는 프로젝트가 아닙니다.
양산 데이터의 변화를 지속적으로 감시하고 모델을 운영하는 장기적인 품질관리 체계가 필요합니다.
5. Data Ops는 검사 데이터를 원인 분석이 가능한 데이터로 바꾼다
검사장비에서 생성되는 데이터는 주로 이미지와 측정값입니다.
하지만 불량 이미지 한 장만으로는 결함의 원인을 찾기 어렵습니다.
해당 제품이 어느 라인에서 생산됐는지, 어떤 설비와 소재가 사용됐는지, 당시 공정속도와 온도, 장력, 압력은 어땠는지가 함께 연결돼야 합니다.
예를 들어 특정 결함이 증가했을 때 다음과 같은 질문에 답할 수 있어야 합니다.
- 특정 소재 Lot에서만 발생했는가?
- 특정 설비나 카메라에서 집중됐는가?
- 라인 속도를 변경한 이후 증가했는가?
- 조명이나 렌즈를 교체한 이후 판정값이 달라졌는가?
- 특정 시간대나 작업조건에서 반복됐는가?
- 설비 유지보수 이후 정상 수준으로 회복됐는가?
이를 위해서는 이미지와 영상뿐 아니라 시계열 데이터, 정형 데이터, 설비·센서 데이터와 제품 이력이 함께 연결돼야 합니다.
PIE가 제안하는 Data Integration 구조 역시 이미지·영상, 시계열, 정형 데이터와 라인·공정·설비·센서 정보를 통합하는 방향입니다.
Data Ops는 단순히 데이터를 한곳에 저장하는 시스템이 아닙니다.
데이터의 형식과 기준을 통일하고, 제품과 공정의 맥락을 부여하며, 어떤 데이터가 어떤 모델 학습과 판정에 사용됐는지 추적할 수 있도록 관리합니다.
Data Ops는 검사 데이터를 불량 기록에서 공정 개선을 위한 데이터 자산으로 바꾸는 역할을 합니다.
6. AI Ops는 AI 모델이 양산 이후에도 작동하게 한다
Data Ops가 데이터를 연결한다면 AI Ops는 AI 모델의 운영을 담당합니다.
AI Ops는 다음과 같은 과정을 관리합니다.
운영 데이터 수집
→ 모델 성능 모니터링
→ 이상 징후 및 Drift 탐지
→ 재검토 대상 선별
→ 추가 학습
→ 성능 검증
→ 모델 배포
→ 버전관리 및 복구
모델 성능이 일정 수준 아래로 떨어지거나 데이터 분포가 기준값을 벗어나면 시스템이 이를 감지하고 알람을 발생시킬 수 있습니다.
새로운 결함이나 판단이 어려운 데이터는 별도로 수집해 작업자가 검토하고, 검증된 데이터를 모델 재학습에 활용할 수 있습니다.
재학습된 모델은 기존 모델보다 성능이 개선됐는지 검증한 뒤 양산라인에 배포해야 합니다.
문제가 발생하면 이전 모델로 복귀할 수 있어야 합니다.
PIE는 공정별 정상 데이터를 Anomaly Detector가 학습한 뒤, 정상과 다른 정도를 Anomaly Score로 계산하는 구조를 제안하고 있습니다. 검사기가 NG로 판정한 데이터를 다시 추론해 진성 NG와 가성 NG 판단을 지원하는 방식입니다.
Anomaly Detection은 모든 불량 유형을 사전에 확보하기 어려운 제조현장에서 특히 유용합니다.
발생빈도가 낮은 불량이나 신규 결함은 충분한 학습 데이터를 확보하기 어렵지만, 정상 상태를 충분히 학습하면 기존 정상 패턴과 다른 제품을 이상 후보로 선별할 수 있기 때문입니다.
다만 AI가 선별한 이상제품을 즉시 폐기하거나 공정을 자동 변경하는 것은 별개의 문제입니다.
초기에는 작업자가 결과를 검증하고, AI의 판단이 안정화되면 자동화 범위를 단계적으로 확대해야 합니다.
AI Ops의 본질은 새로운 AI 모델을 계속 만드는 것이 아닙니다.
이미 배포된 모델이 변화하는 생산환경에서도 지속적으로 성능을 유지하도록 관리하는 것입니다.